
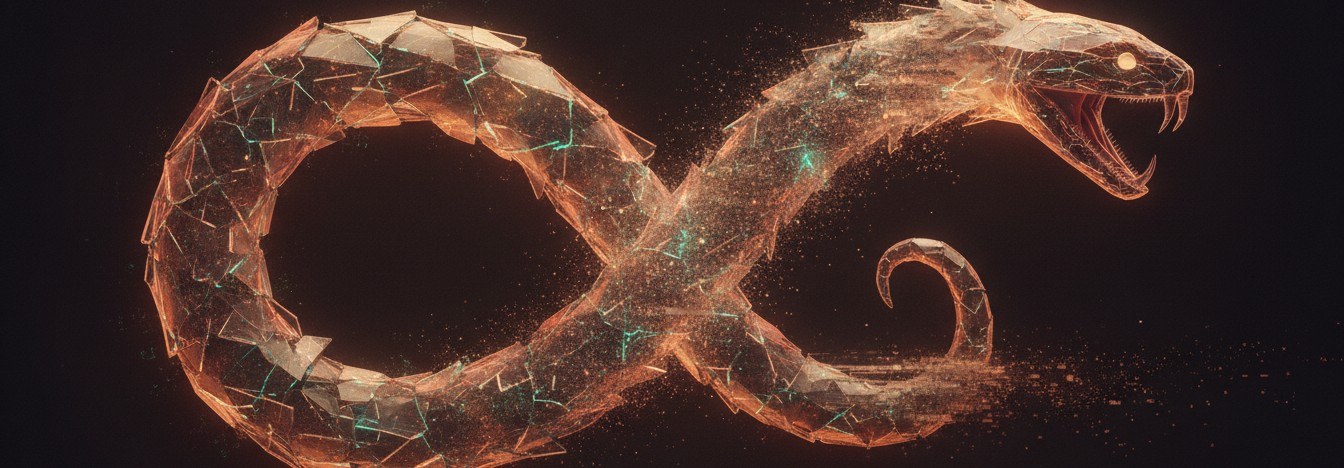
Bir düşünün: Aynaya bakıp çektiğiniz fotoğrafı tekrar aynaya yansıtıyorsunuz, sonra o yansımayı bir daha fotoğraflıyorsunuz. Birkaç tekrardan sonra görüntü bozulur, netliğini kaybeder, sonunda anlamsız bir bulanıklığa dönüşür. İşte model çöküşü denen olgu, yapay zeka dünyasında tam olarak bunu yapıyor. Modeller artık insan değil, kendi ürettikleri içerikle besleniyor ve bu durum sessizce, fark edilmeden büyüyen bir krizi tetikliyor.
Son yıllarda büyük dil modellerinin eğitimi için kullanılan "temiz" insan verisi giderek azalıyor. İnternet artık yapay zeka tarafından üretilen metinlerle dolup taşıyor. Bu da araştırmacıların "veri kıtlığı" dediği garip bir paradoksu doğuruyor: veri bolluğu çağında, gerçek ve güvenilir veri kıtlığı yaşanıyor.
Model Çöküşü Tam Olarak Nedir?
Model çöküşü, bir yapay zeka modelinin kendi ürettiği sentetik verilerle tekrar tekrar eğitilmesi sonucu zamanla kalitesinin, çeşitliliğinin ve doğruluğunun bozulması anlamına geliyor. Basitçe söylemek gerekirse, model kendi hatalarını, önyargılarını ve basmakalıp ifadelerini bir sonraki nesile aktarıyor. Her yeni nesil, bir önceki neslin "yankısı" oluyor ama bu yankı her tekrarında biraz daha bozuluyor.
Araştırmacılar bu süreci üç aşamada tanımlıyor. İlk aşamada model, nadir görülen ama gerçek olan bilgileri unutmaya başlıyor. İkinci aşamada çeşitlilik azalıyor; model giderek daha tekdüze, daha "ortalama" cevaplar üretiyor. Üçüncü ve en tehlikeli aşamada ise model, gerçeklikten tamamen kopuk, anlamsız veya tutarsız içerikler üretmeye başlıyor.
Bir modelin "unutması" aslında insan unutkanlığından çok daha tehlikeli; çünkü model ne unuttuğunu bilmiyor, sadece giderek daha emin bir şekilde yanlış konuşuyor.
Sentetik Veri Neden Bu Kadar Riskli?
Yapay zeka şirketleri, maliyet ve hız avantajı sağladığı için sentetik veriye giderek daha fazla yöneliyor. Gerçek insan verisi toplamak pahalı, yavaş ve etik açıdan hassas bir süreç. Oysa bir modelin ürettiği metinle başka bir modeli eğitmek çok daha kolay görünüyor. Ancak bu kestirme yol, uzun vadede ciddi bir bedel doğuruyor.
Sentetik veri, insan deneyiminin o eşsiz dokusunu taşımıyor. Kültürel nüanslar, duygusal incelikler, yerel deyimler, hatalar, tereddütler ve yaratıcı sapmalar kayboluyor. Geriye kalan şey, istatistiksel olarak "en olası" cevapların steril bir birleşimi oluyor. Bu da yapay zeka eğitimi sürecinin temelini sarsan bir zayıflık yaratıyor.
- Çeşitlilik kaybı: Modeller giderek birbirine benzeyen, sıradan cevaplar üretiyor.
- Nadir bilgi erozyonu: Az rastlanan ama değerli bilgiler sistemden siliniyor.
- Hata birikimi: Küçük yanlışlar, her eğitim döngüsünde katlanarak büyüyor.
- Gerçeklikten kopuş: Model, dünyayı değil kendi önceki versiyonunu temsil etmeye başlıyor.
İnternetin Kirlenmesi ve AI İçerik Kirliliği
Bugün internette yayınlanan içeriklerin önemli bir kısmının yapay zeka tarafından üretildiği tahmin ediliyor. Bu durum, geleceğin modellerinin eğitileceği "havuzu" kirletiyor. Arama motorları, forumlar, haber siteleri ve sosyal medya; hepsi giderek daha fazla sentetik metinle doluyor. Bu da AI içerik kirliliği olarak adlandırılan bir fenomeni ortaya çıkarıyor.
İşin ürkütücü tarafı şu: Bu kirlilik geri dönüşü zor bir sarmal yaratıyor. Yeni modeller, kirlenmiş internetten veri topluyor. Bu verilerle eğitilen modeller daha fazla sentetik içerik üretiyor. Üretilen içerik yine internete karışıyor ve döngü kendini besleyerek devam ediyor. Bazı araştırmacılar, bu sürecin birkaç yıl içinde "temiz" insan verisine ulaşmayı neredeyse imkânsız hale getirebileceğini öne sürüyor.
Bu riskler, yapay zekanın güvenilirliğiyle ilgili başka tartışmaları da gündeme getiriyor. Örneğin yapay zekanın gerçeği görmezden gelme eğilimi, model çöküşüyle birleştiğinde kullanıcıların yanlış bilgiyle daha sık karşılaşma ihtimalini artırıyor.
Bu Sessiz Tehlike Neden Şimdi Konuşuluyor?
Model çöküşü kavramı akademik çevrelerde uzun süredir tartışılsa da, üretken yapay zeka araçlarının gündelik hayata bu kadar hızlı girmesiyle birlikte konu artık sadece araştırmacıların değil, herkesin ilgilendiği bir mesele haline geldi. Çünkü bu sorun sadece şirketlerin teknik bir başarısızlığı değil, aynı zamanda bilgiye erişimin güvenilirliğini doğrudan etkileyen bir durum.
Düşünün ki gelecekte arama yaptığınızda karşınıza çıkan sonuçların büyük bir kısmı, aslında bir yapay zekanın başka bir yapay zekadan öğrendiği, hiçbir insan gözetiminden geçmemiş bilgiler olabilir. Bu senaryoda yanlış bir tıbbi bilgi, hatalı bir tarihsel veri veya çarpıtılmış bir istatistik, binlerce kez tekrarlanarak "gerçek" gibi görünmeye başlayabilir.
Bu tür güven sorunları, yapay zekanın insan hayatına nasıl nüfuz ettiğiyle de ilgili. Örneğin ses klonlama teknolojilerinin kötüye kullanımını ele alan ses klonlama dolandırıcılığı üzerine yazımız, yapay zekanın üretim kalitesi düştükçe toplumsal güvenin de nasıl zarar görebileceğini gösteriyor.
Bu Çöküşü Önlemenin Yolları Var mı?
Araştırmacılar ve şirketler bu sorunu tamamen görmezden gelmiyor. Çeşitli çözüm önerileri geliştiriliyor:
- Veri kökeni takibi: İçeriğin insan mı yoksa yapay zeka tarafından mı üretildiğini belirleyen filigran ve etiketleme sistemleri geliştiriliyor.
- Kaliteli insan verisi koruma: Bazı kurumlar, arşiv niteliğindeki eski insan verilerini özenle saklayıp "altın standart" olarak kullanmayı planlıyor.
- Hibrit eğitim yöntemleri: Sentetik veri tamamen reddedilmek yerine, insan verisiyle dengeli bir şekilde harmanlanıyor.
- Daha sıkı değerlendirme süreçleri: Model çıktıları, yayına girmeden önce daha titiz insan denetiminden geçiriliyor.
Ancak bu çözümlerin hiçbiri kusursuz değil. Veri kökeni takibi henüz standartlaşmamış durumda ve kötü niyetli aktörler bu etiketleri kolayca atlatabiliyor. Bu yüzden model çöküşü, yakın gelecekte yapay zeka sektörünün en büyük gündem maddelerinden biri olmaya devam edecek gibi görünüyor.
Kullanıcılar İçin Bu Ne Anlama Geliyor?
Sıradan bir kullanıcı olarak bu teknik sorunun sizi neden ilgilendirdiğini merak ediyor olabilirsiniz. Cevap basit: Kullandığınız sohbet botları, arama önerileri ve içerik üretim araçları zamanla daha az güvenilir hale gelebilir. Bu da dijital okuryazarlığın her zamankinden daha kritik hale geldiği anlamına geliyor.
Bilgiyi tek bir kaynaktan, özellikle de yapay zeka çıktısından almak yerine çapraz kontrol yapmak, kaynak göstermeyen iddialara şüpheyle yaklaşmak ve güvenilir, insan tarafından denetlenen platformları tercih etmek giderek daha önemli bir alışkanlık haline geliyor.
Sonuç olarak, yapay zekanın kendi kuyruğunu ısırması sadece teknik bir merak konusu değil. Bu sessiz tehlike, internetin ve bilginin geleceğini doğrudan şekillendiriyor. Model çöküşü, belki de yapay zeka çağının en az konuşulan ama en çok dikkat gerektiren sorunlarından biri olarak önümüzde duruyor.
Sık Sorulan Sorular
Model çöküşü tam olarak nedir?
Model çöküşü, bir yapay zeka modelinin kendi ürettiği sentetik verilerle tekrar eğitilmesi sonucunda zamanla kalitesinin, çeşitliliğinin ve doğruluğunun bozulmasıdır. Model, nadir bilgileri unutmaya başlar, cevapları tekdüzeleşir ve sonunda gerçeklikten kopuk içerikler üretebilir. Bu süreç insan denetimi olmadan fark edilmeden ilerleyebilir.
Sentetik veri neden bu kadar sorunlu kabul ediliyor?
Sentetik veri, insan deneyiminin doğal çeşitliliğini, kültürel nüanslarını ve duygusal inceliklerini taşımaz. Bir model başka bir modelin ürettiği veriyle eğitildiğinde, küçük hatalar ve önyargılar her döngüde katlanarak büyür. Bu da zamanla modelin gerçek dünyayı değil, kendi önceki versiyonunu yansıtmasına yol açar.
İnternetin AI içerikle dolması model çöküşünü nasıl hızlandırıyor?
İnternette yapay zeka üretimi içerik arttıkça, gelecekteki modellerin eğitileceği veri havuzu da kirleniyor. Yeni modeller bu kirlenmiş veriden öğreniyor ve daha fazla sentetik içerik üretiyor. Bu kendi kendini besleyen döngü, temiz ve güvenilir insan verisine ulaşmayı giderek zorlaştırıyor.
Model çöküşünü önlemek için neler yapılıyor?
Araştırmacılar veri kökeni takibi, filigranlama, insan verisinin arşivlenmesi ve hibrit eğitim yöntemleri gibi çözümler geliştiriyor. Ayrıca model çıktılarının yayına girmeden önce daha sıkı insan denetiminden geçirilmesi öneriliyor. Ancak bu yöntemlerin hiçbiri henüz tam anlamıyla standartlaşmış değil.
Sıradan bir kullanıcı model çöküşünden nasıl etkilenir?
Model çöküşü ilerledikçe sohbet botları ve arama önerileri gibi araçlar zamanla daha az güvenilir hale gelebilir. Bu durum, bilgiyi tek kaynaktan almak yerine çapraz kontrol yapmayı ve güvenilir, insan denetimli kaynaklara yönelmeyi daha da önemli hale getirir.
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yapın.
Yorum Yaz
Yorumunuz yayınlanmadan önce moderasyon onayından geçer.